AI用語の違いは、「広い概念」「学習の方法」「モデル」「サービス」「情報を補う仕組み」に分けると理解しやすくなります。
例えば、AIは人の知的な作業をコンピューターで再現・支援する技術の広い概念です。生成AIは文章や画像などを生成する技術分野、LLMは言語を扱う大規模なモデル、RAGは外部情報を検索して生成に利用する仕組みを指します。同じ種類の名前として横並びに覚えると、役割を取り違えやすくなります。
この記事では、生成AIを学び始めた人や、仕事でAIサービスを使う人に向けて、混同しやすい用語の意味・関係・使い分けを比較表と具体例で整理します。
AI用語の違いを理解するための全体像
最初に確認したいのは、それぞれの言葉が「何を説明しているか」です。技術の名前とサービスの名前、モデルと活用方法を分けるだけでも、説明を読み解きやすくなります。
各用語の意味と身近な具体例から学びたい方は、初心者向け生成AI用語20選を確認してから、この比較表へ戻ると関係を整理しやすくなります。
| 用語 | 主に説明しているもの | 一言でいうと |
|---|---|---|
| AI | 広い技術概念 | 人の知的な作業を再現・支援する技術 |
| 機械学習 | 学習の方法・技術分野 | データからパターンを学ぶ方法 |
| ディープラーニング | 機械学習の一分野 | 多層のニューラルネットワークを使う方法 |
| 生成AI | 技術分野・機能 | 文章・画像・音声などを生成するAI |
| LLM | モデルの種類 | 大量のデータで学習した大規模な言語モデル |
| ChatGPT | サービス | 生成AIモデルを利用できる対話型サービス |
| RAG | 情報を補う仕組み | 外部情報を検索し、回答生成に利用する方法 |
| ファインチューニング | モデルを調整する方法 | 学習済みモデルを追加学習で用途に適応させる方法 |
| AIエージェント | システム・動作の仕組み | 目標に向けて判断し、必要な処理を進める仕組み |
この表は、用語を一つの上下関係に並べたものではありません。「機械学習」は作り方に関係し、「生成AI」は生成という働きに関係します。「ChatGPT」は利用者が操作するサービスです。
また、一つのサービスに複数の技術が組み合わされることもあります。LLMで文章を生成し、RAGで社内資料を参照し、AIエージェントの仕組みで作業を進める、といった構成です。
用語を見かけたら、まず次の点を確認しましょう。
- 技術全体の話か、特定のモデルの話か
- モデルの作り方か、利用するときの仕組みか
- サービス名か、サービス内部の機能名か
この区別ができると、「RAGとLLMはどちらが高性能か」といった、比較軸の異なる問いにも気づけます。RAGとLLMは競合する製品名ではなく、組み合わせて使える関係だからです。
AI・生成AI・LLM・ChatGPTの違い
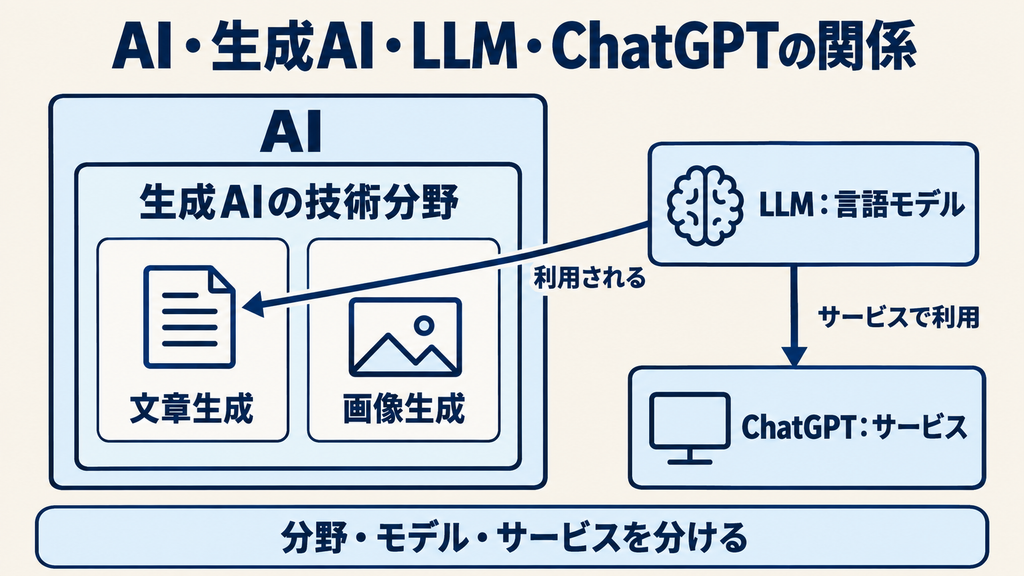
AIは広い概念、生成AIは生成を行う技術分野、LLMはモデルの種類、ChatGPTはサービスです。四つの言葉を同じ階層の名称として扱わないことが、理解の出発点になります。
AIと生成AIの違いは「生成するか」だけで全体を判断しない
AIには、画像を分類する、需要を予測する、異常を検出するなど、さまざまな用途があります。文章や画像を作ることだけがAIの役割ではありません。
一方、生成AIは、学習したパターンをもとに文章・画像・音声などを生成する技術です。例えば、メールの下書きを作る、説明文を要約する、イラストを生成するといった使い方があります。IBM
| 比較項目 | AI | 生成AI |
|---|---|---|
| 言葉の範囲 | 広い技術概念 | AIの技術分野の一つ |
| 主な用途の例 | 分類、予測、検出、判断支援など | 文章、画像、音声などの生成 |
| 具体例 | 需要予測、画像分類 | メール作成、画像生成 |
| 関係 | 生成AIを含む広い概念 | AIの一分野 |
ただし、「従来のAIは判断だけ、生成AIは作成だけ」と完全に分けると実態から離れます。生成AIモデルを分類や分析に利用することもあるためです。
違いを覚えるときは、用途を固定するより、AIは広い概念、生成AIは生成に関わる分野と整理するほうが適切です。
詳しい意味は、AI(人工知能)の解説と生成AIの解説で確認できます。
生成AIとLLMの違いは「分野」と「モデル」
LLMはLarge Language Modelの略で、日本語では大規模言語モデルと呼ばれます。大量のデータから言語のパターンや関係を学習し、文章の生成や要約などに利用されるモデルです。
生成AIには文章だけでなく、画像・音声・動画などを生成する技術も含まれます。そのため、生成AI全体とLLMを同じ意味で使うことはできません。
例えば、「生成AIで商品画像を作る」という説明だけでは、そのサービスがどのモデルを使っているかまでは分かりません。画像生成モデルと、指示の解釈を担う言語モデルが組み合わされている可能性もあります。
比較するときは、次のように分けましょう。
- 生成AI:どのような働きをする技術か
- LLM:その働きを実現するモデルの種類は何か
「LLMを使って文章を生成する」は自然な説明です。一方、「生成AIはすべてLLMである」という説明では、画像などを扱う別のモデルを捉えられません。
詳しくは、大規模言語モデル(LLM)の解説をご覧ください。
LLMとChatGPTの違いは「モデル」と「利用するサービス」
LLMはモデルの種類を表す言葉です。ChatGPTは、生成AIモデルを対話形式などで利用するためのサービス名です。
利用者が目にする画面、会話の管理、ファイルを扱う機能などは、モデルそのものとは区別して考える必要があります。
例えば、同じ種類のモデルでも、利用するサービスや組み合わせる機能によって、できる作業は変わります。
そのため、AIサービスを比較するときは、モデルの能力だけでなく、必要な情報へアクセスできるか、どのような操作ができるかも確認しましょう。「モデルが高性能」という説明だけでは、サービス全体の使い勝手までは判断できません。
機械学習・ディープラーニング・生成AIの違い
機械学習とディープラーニングは、主にデータから学習する方法を説明する言葉です。生成AIは、生成という働きに着目した言葉であり、比較する視点が異なります。
機械学習とディープラーニングの関係
機械学習は、データからパターンを学び、新しいデータの予測や分類などに利用する技術です。ディープラーニングは機械学習の一分野で、多層のニューラルネットワークを使います。
| 用語 | 意味 | 理解するときのポイント |
|---|---|---|
| 機械学習 | データからパターンを学ぶ技術 | 複数の手法を含む |
| ディープラーニング | 多層のニューラルネットワークを使う機械学習 | 機械学習の一分野 |
| 生成AI | 文章や画像などを生成するAI | 学習方法とは異なる観点の分類 |
例えば、売上予測のモデルと文章生成のモデルは、どちらも機械学習を利用していても、目的や出力が異なります。
「機械学習だから文章を作れない」「ディープラーニングだから生成AIである」とは判断できません。どの方法で学習したかと、何に使うモデルかを分けて見る必要があります。
基盤モデルとLLMも同じ意味ではない
基盤モデルは、幅広いデータで事前学習され、さまざまな用途の基礎として利用できるモデルを指します。言語を扱うものに限らず、画像などを扱う基盤モデルもあります。
LLMは言語モデルの種類、基盤モデルは幅広い用途の土台としての性質に着目した呼び方です。二つの言葉は重なる部分がありますが、完全な同義語ではありません。
用語の関係をさらに確認したい場合は、基盤モデルの解説が参考になります。
RAG・ファインチューニング・プロンプトの違い
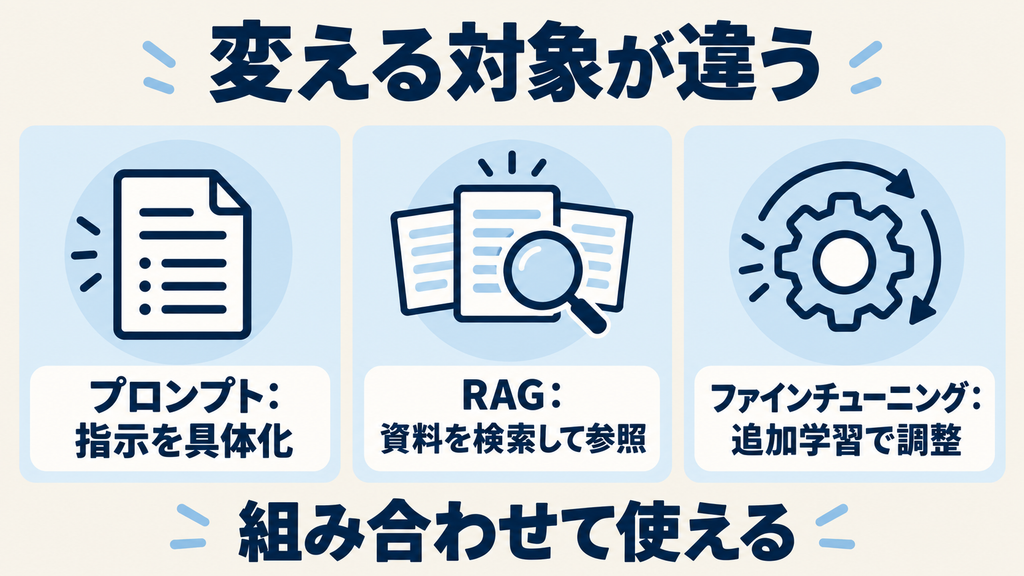
回答を改善する方法として並べられやすい三つの用語ですが、変える対象が異なります。プロンプトは入力する指示、RAGは回答時に参照する情報、ファインチューニングは追加学習によるモデルの調整に関わります。
三つの方法を比較する
| 比較項目 | プロンプトの工夫 | RAG | ファインチューニング |
|---|---|---|---|
| 主に変える対象 | 指示・条件・例 | 回答時に参照する外部情報 | 学習済みモデルの振る舞いなど |
| 基本的な方法 | 入力内容を具体化する | 関連情報を検索して生成に渡す | データを使って追加学習する |
| モデルの追加学習 | 通常は行わない | RAG自体には必須ではない | 行う |
| 活用例 | 回答形式を指定する | 社内規程に基づいて回答する | 特定の形式や作業に適応させる |
RAGはRetrieval-Augmented Generationの略で、日本語では検索拡張生成と呼ばれます。質問に関係する情報を外部の資料などから検索し、その情報を回答生成に利用する仕組みです。
一方、ファインチューニングは、学習済みモデルを特定の用途へ適応させる追加学習です。モデル全体を更新する方法だけでなく、一部や追加した学習可能な部分を調整する方法もあります。
RAGは「その場で資料を参照する」仕組み
社内の休暇制度について質問する場面を考えてみましょう。
RAGを利用した構成では、質問に関連する就業規則や社内規程を検索し、見つかった記述をモデルに渡して回答を作ります。回答に必要な情報を、モデルの学習内容だけで賄う必要がなくなります。
ただし、資料を追加すれば自動的に正確な回答になるわけではありません。古い資料を検索した、必要な箇所を見つけられなかった、記述を読み違えた、といった問題は起こり得ます。
運用を考える場合は、次のような確認が必要です。
- どの資料を参照対象にするか
- 資料の更新日や有効期間を管理できるか
- 利用者に閲覧権限がある資料か
- 回答と根拠の記述が対応しているか
RAGの基本は、RAGの意味・仕組みの解説で詳しく確認できます。
ファインチューニングは「用途に合わせて追加学習する」方法
ファインチューニングでは、学習済みモデルに追加のデータを使って学習させ、特定の作業や表現などへの適応を図ります。
例えば、一定の形式で回答する傾向を整える、分野に固有の作業に適応させる、といった用途があります。専門知識を学習させる場合もあるため、「知識には使えず、文体だけを変える方法」と限定するのも正確ではありません。IBM
ただし、規程が変わるたびに情報を更新したい場合は、追加学習の方法だけでなく、外部資料を参照する構成も検討する必要があります。
どちらが優れているかを先に決めるのではなく、更新したいのは参照情報か、モデルの振る舞いかを確認することが大切です。
RAGとファインチューニングは併用できる
RAGとファインチューニングは、必ずどちらか一つを選ぶ関係ではありません。
用途に合わせて調整したモデルに、RAGで取得した資料を渡す構成も考えられます。研究でも、両者を組み合わせた構成が検討されています。
また、導入の目的が回答形式を整えることなら、まず指示や例の与え方で対応できるかを確認するという進め方もあります。必要な効果と運用負担を整理し、実際の質問で評価して選びましょう。
学習・推論・検索の違い
学習はモデルを作る・調整する処理、推論は学習済みモデルを利用する処理、検索は必要な情報を探す処理です。「AIが回答した」という一つの場面にも、複数の処理が関わることがあります。
| 用語 | 主に行うこと | 例 |
|---|---|---|
| 学習 | データを使ってモデルを調整する | 文章のパターンを学ぶ |
| 推論 | 学習済みモデルで入力を処理する | 質問への回答を生成する |
| 検索 | 条件に合う情報を探す | 社内規程の該当箇所を取得する |
機械学習の文脈でいう推論は、学習済みモデルを新しい入力へ適用する処理です。日常語の「筋道を立てて考える」という意味だけで捉えると、技術説明を読み違えることがあります。
例えば、RAGを利用した回答では、先に資料を検索し、その検索結果を含む入力をモデルが処理して文章を生成します。この回答時の処理と、モデルを追加学習する処理は別です。
そのため、「資料を読ませた」「会話で訂正した」という表現だけでは、モデルの追加学習が行われたかは判断できません。入力として一時的に参照したのか、別の保存機能を使ったのか、学習に利用される設定なのかを分けて確認する必要があります。
サービスのデータ利用条件については、技術用語の意味だけで結論を出さず、利用するサービスの規約や設定を確認しましょう。
学習の方法は機械学習の解説で確認できます。検索の方法は、キーワード検索とセマンティック検索の違いも参考になります。
チャットボット・AIエージェント・RAGの違い
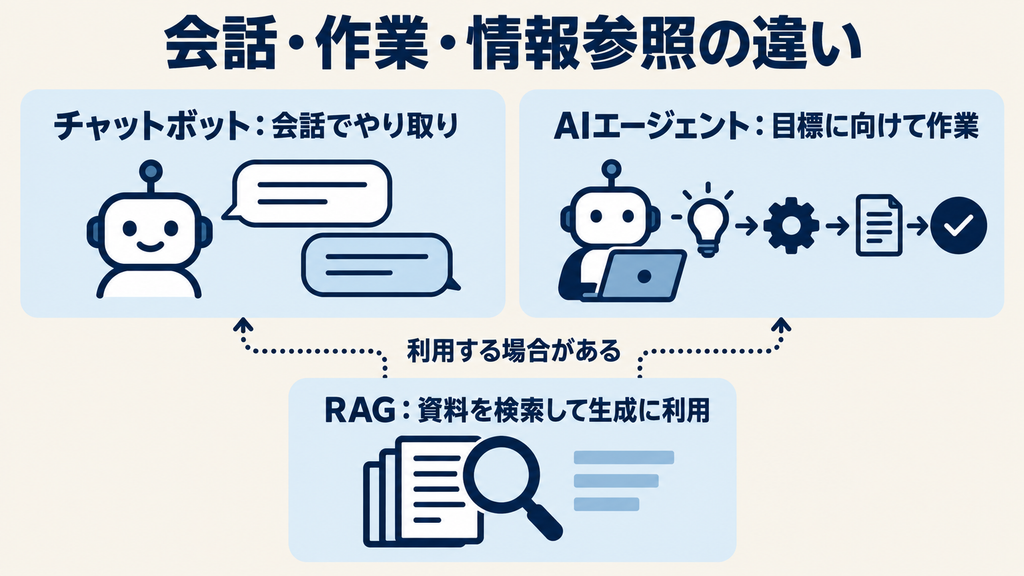
チャットボットは会話形式でやり取りする仕組み、AIエージェントは目標に向けて処理を進める仕組みです。RAGは、その内部で情報を参照するために利用できる方法です。
会話できることと、作業を進められることは異なる
チャットボットという呼び方だけでは、内部の技術は分かりません。決められた応答を返す仕組みも、生成AIモデルで文章を作る仕組みもあります。
AIエージェントでは、目標や利用可能なツールに応じて、必要な作業を判断し、処理を進める点に注目します。ただし、自律性の程度や実行できる操作はシステムによって異なります。IBM
例えば、「売上報告を作ってほしい」という依頼には、次のような段階があります。
- 集計方法を文章で説明する
- データを取得して集計する
- 結果を確認して報告書を作る
- 報告書を所定の場所へ保存する
会話で提案することと、外部のデータやツールを使って作業を進めることは、別の能力です。
また、チャット画面からAIエージェントを操作することもできます。画面が会話形式だからといって、回答だけを行うシステムとは限りません。
RAGを使っていてもAIエージェントとは限らない
RAGは、関連情報を検索して生成に利用する方法です。検索した資料に基づいて回答するだけの構成でも利用できます。
一方、AIエージェントは、目標に向けて処理を進めるシステムです。必要な情報を集める手段としてRAGを使う場合もあります。IBM
整理すると、RAGは「何を根拠に回答するか」、AIエージェントは「どのように作業を進めるか」に関わる言葉です。
サービスを選ぶときは、「エージェント対応」といった名称だけで判断せず、実際にできる操作、必要な権限、人の確認が入る場面を具体的に確かめましょう。
AI用語の違いを仕事の場面で使い分ける
用語の理解を実務につなげるには、目的・参照情報・必要な操作を分けて考えると役立ちます。以下は使い分けを理解するための一般的な例です。
社内システムで組み合わせる仕組みまで知りたい方は、AI開発・導入で使う用語集で接続・データ活用・作業・評価の役割を確認できます。
| やりたいこと | 関係する用語 | 確認するポイント |
|---|---|---|
| メールの下書きを作る | 生成AI、LLM、プロンプト | 相手・目的・文体を伝えられるか |
| 社内規程に沿って回答する | LLM、RAG | 現行の資料を参照できるか |
| 特定の回答形式へ適応させる | プロンプト、ファインチューニング | 指示で足りるか、追加学習が必要か |
| 複数の作業をまとめて進める | AIエージェント | ツール・権限・確認手順があるか |
| 売上や需要を予測する | AI、機械学習 | 目的に合ったデータと評価方法があるか |
例えば、社内規程を扱うなら、文章が自然かどうかだけでなく、回答がどの資料に基づいているかが重要です。作業を自動化するなら、文章を生成できることに加えて、必要なシステムへアクセスできるかを確認します。
また、生成された回答が自然でも、内容が正しいとは限りません。事実と異なる内容や、存在しない資料などをもっともらしく示すハルシネーションは、生成AIを利用する際の重要な確認事項です。IBM
用語の違いを知る目的は、名前を暗記することだけではありません。「どの機能が必要か」「何を確認すればよいか」を具体的に説明できるようになることです。
AI用語の違いに関するよくある質問
ここでは、関係を取り違えやすい疑問を短く整理します。
AI・生成AI・LLMは同じ意味ですか?
同じ意味ではありません。AIは広い技術概念、生成AIは生成を行う技術分野、LLMは言語を扱うモデルの種類です。広い概念と、機能に着目した分野、モデルの名称を分けて理解しましょう。
ChatGPTはLLMそのものですか?
ChatGPTはサービスです。内部で利用されるモデルと、利用者が操作する画面や機能を含むサービス全体は区別します。
RAGとLLMはどちらを選べばよいですか?
二者択一ではありません。LLMはモデル、RAGは外部情報を検索して生成に利用する仕組みです。LLMを使ったシステムにRAGを組み合わせることがあります。
RAGを使えばハルシネーションはなくなりますか?
なくなるとはいえません。参照情報を補うことで誤りを減らす助けになりますが、検索漏れ、古い資料、読み違いなどは起こり得ます。重要な回答は、根拠となる資料と照合する必要があります。IBM
ファインチューニングは、長い指示文を入力することですか?
異なります。通常の指示文の入力は、回答時に条件を伝える操作です。ファインチューニングは、データを使って学習済みモデルを追加学習で調整する方法です。
AIエージェントは人の確認なしで何でもできますか?
できる操作は、システムの設計、利用可能なツール、権限などに依存します。自律性があっても、目標やルールは必要です。影響の大きい操作では、人が確認する手順を設けることも重要です。IBM
まとめ|AI用語の違いは役割と関係で整理する
混同しやすいAI用語は、何を説明する言葉なのかを確認すると整理できます。
- AIと生成AI:広い概念と、生成に関わる技術分野
- 生成AIとLLM:技術分野と、モデルの種類
- LLMとChatGPT:モデルと、利用するサービス
- RAGとファインチューニング:外部情報の参照と、追加学習による調整
- 学習と推論:モデルを調整する処理と、学習済みモデルを利用する処理
- チャットボットとAIエージェント:会話によるやり取りと、目標に向けた作業の進行
これらは、すべてを一列の上下関係に並べられる言葉ではありません。一つのサービスに複数のモデルや仕組みが組み合わされることもあります。
分からない用語に出会ったら、「概念・方法・モデル・サービス・仕組み」のどれに当たるかを確認し、前後の説明と合わせて理解していきましょう。
分からない言葉は、生成AI用語集で意味や関連用語を確認できます。「概念・方法・モデル・サービス・仕組み」のどれに当たるかを考えながら、似た用語との違いを整理しましょう。
出典・参考情報
以下は、本文の技術的な定義・関係・限界を確認した一次情報です。具体例は理解のために作成したものであり、AWLの導入実績や性能検証を示すものではありません。
AI・モデル・学習の出典
| 発信元・資料 | 本文で確認した内容 |
|---|---|
| IBM「What is artificial intelligence (AI)?」 | AIの概念、関連分野、基盤モデル |
| IBM「What is generative AI?」 | 生成AIの意味と生成対象 |
| IBM「What are large language models (LLMs)?」 | LLMの意味、用途、サービスとの関係 |
| IBM「What is machine learning?」 | 機械学習、ディープラーニング、学習と推論 |
情報参照・エージェント・品質の出典
| 発信元・資料 | 本文で確認した内容 |
|---|---|
| IBM「What is retrieval augmented generation (RAG)?」 | 外部情報を検索して生成に利用する仕組み |
| IBM「What is fine-tuning?」 | 追加学習による用途への適応、調整方法 |
| IBM「What are AI agents?」 | 目標、ツール、判断、作業の進行、人の監督 |
| IBM「What are AI hallucinations?」 | ハルシネーションの意味と限界 |
| Balaguerほか「RAG vs Fine-tuning: Pipelines, Tradeoffs, and a Case Study on Agriculture」 | RAGとファインチューニングを併用する構成 |